
记录给国模补充识图和联网能力
这两天把 Claude Code 的 ANTHROPIC_BASE_URL 改成了智谱的兼容接口,跑 GLM-5.2 写代码。不得不说,国内这几家模型现在补全和重构确实够用,成本比直接刷 Claude 官方便宜了一大截。
但用了半天,踩到两个特别恶心的坑:
- 一发截图就 400 报错:因为中继和国产模型接口基本只认文本,多模态 payload 丢过去直接当场暴毙。
web_fetch工具彻底废掉:Claude Code 自带的抓网页工具是跑在 Anthropic 自己服务端的一套逻辑,切到第三方 Base URL 后根本不通。问稍微新一点的技术(比如 React 19 的改动),它要么直接开始胡说八道,要么报 tool use 失败。
总不能只用来写离线代码吧?周末花了几个小时,用胶水代码把这两个功能给补上了,记录下踩坑过程。
1. 搞定识图:拦截剪贴板 + Skill 垫一层小模型
多模态这个坑,主要问题出在 Claude Code 的 VSCode 插件上——你在对话框里按 Ctrl+V,插件默认会把图片 base64 塞到消息体里发给模型。
但既然兼容接口不支持直接传图,思路就很简单:不要把图片交给主模型,让它走侧枝。
我做的事情分两步:
- 改了下插件的粘贴逻辑:顺着插件代码定位到粘贴事件,加了一行简单的拦截:把图片先落盘存到本地的临时目录(比如
.claude/tmp/),然后把剪贴板替换成图片的本地路径文本发出去。 - 写了个叫
/recognize-image的 Skill:告诉 Claude Code,只要在上下文里看到图片路径,就不要自己去硬解,直接调这个 skill。这个 skill 底层其实就是个 Python 脚本,拿着路径把图片扔给便宜的国产视觉模型(比如 Qwen-VL 或者 GLM 的多模态接口),让小模型把图里的报错、UI 结构或者 OCR 文字提取出来,再把文本拼回对话里。
虽然方案极其粗暴,但实际用起来基本无感,截图一贴,主模型就能看到图片转出来的文字描述。
2. 搞定联网:干掉原生工具,换 MCP + Tavily 轮询
web_fetch 挂了之后,唯一的路子就是走 MCP(Model Context Protocol)。
我的配置是直接在规则提示词(.clauderc)里强行加了一条硬规则:全局禁用 web_fetch。然后配了两个 MCP 服务补位:
- Tavily:专门针对大模型做过清洗的搜索 API,主力查文档。
- cc-web:简单的抓取工具,用于指定 URL 的正文兜底提取。
Claude Code 的 mcpServers 配置参考:
{ "mcpServers": { "tavily": { "command": "npx", "args": ["-y", "@tavily/mcp"], "env": { "TAVILY_API_KEY": "你的key" } } }}这里有个小坑:Tavily 免费版每个月只有 1000 次调用的额度,查几次技术文档很快就见底了。我懒得充钱,就注册了两个号,写了个很轻量的小代理在本地对请求做 key 轮询。如果不想折腾,老老实实充点钱或者换成其它免费搜索的 MCP 也一样。
实际效果
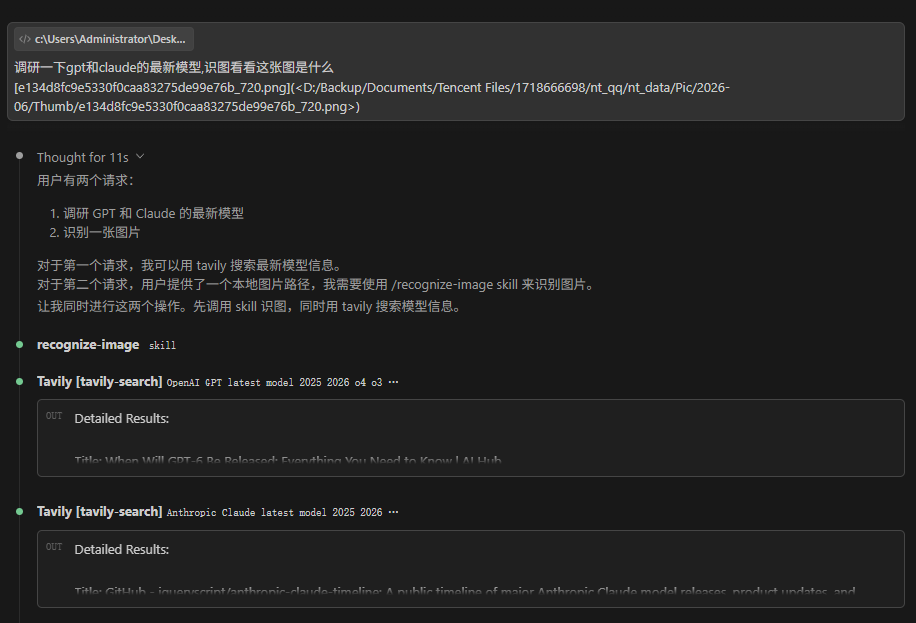
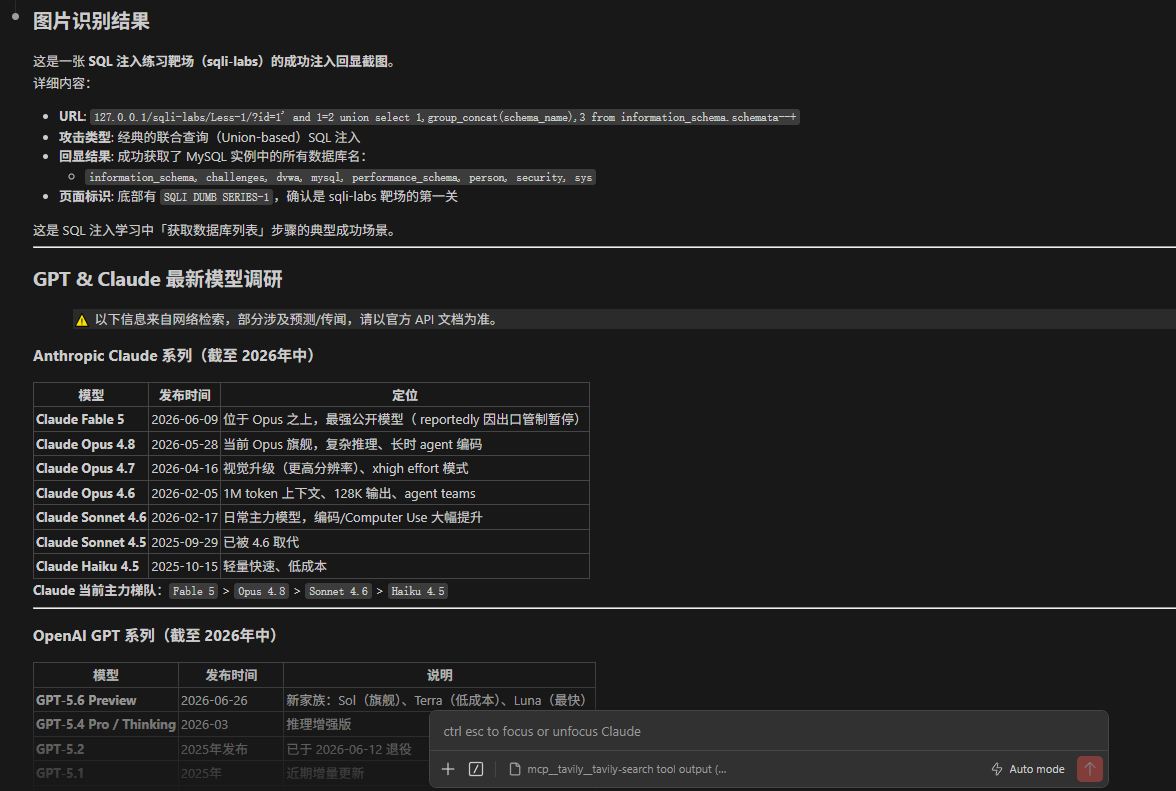
全部打通之后试了一次:随手截了一张 SQL 注入靶场的报错图贴进去,同时让它去查最近几个大模型官方发布的更新日志。
后台跑的时候两个进程是并行的:一边调用本地 skill 跑脚本把靶场的 payload 和回显文本读出来,另一边走 Tavily 搜到了官方最新的更新文档。最后返回的回答里,靶场分析和最新资讯都在,没有再出现之前的胡编乱造或者直接报错中断。
折腾完这套缝合怪方案,目前用下来还算顺手,代码补全速度快、便宜,也能凑合读图和联网查文档了。
但缺点也挺明显。VSCode 插件每次更新,我都得防着它把我魔改的粘贴拦截逻辑覆盖掉;外挂一层小模型做 OCR,延迟也肯定不如原生多模态。
国内几家做模型中继和 API 的厂商,如果真想抢开发者市场,还是赶紧把 Anthropic 的兼容层协议做完整吧。用户自己写代理、写 Skill、魔改插件来擦屁股,确实太折腾了。
相关配置和 Skill 的调用脚本改天整理下放 GitHub,有同样需求的朋友也可以照着这个思路改。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!