
Appearance
第 02 篇|大模型的底层直觉:为什么它会“像天才一样创作,像智障一样胡扯”?
导读:
刚接触 AI 的人,往往在两个极端之间反复横跳:今天看到它秒写代码,惊呼“人类要失业了”;明天看它坚称“林黛玉倒拔垂杨柳”,又嘲笑“这玩意儿就是人工智障”。
为什么同一个模型,能写出惊艳全场的文案,却又会一本正经地胡说八道?
这一篇,我们撕开 AI 华丽的外衣,带你看透它的底层脑回路。读懂了它的弱点,你才不会被它带进沟里,才能真正成为驾驭它的总指挥。
一、 两个让你怀疑人生的经典“翻车”场景
只要你用过一段时间 AI,十有八九遭遇过这两种精神暴击:
场景一:一本正经的“学术胡诌”
你让 AI 帮你调研:“请列出 2024 年关于某技术的前三篇经典论文和作者。”
AI 毫不犹豫,啪啪列出三篇:英文标题高大上、作者是常青藤教授、期刊名精准匹配。你兴奋地去 Google 搜索,结果查无此文,连教授最近三年都没写过这方向的论文——这三篇论文,完全是 AI 凭空捏造出来的。
场景二:写代码时的“幽灵函数”
你让 AI 写个小功能:“把用户上传的 Excel 转成 PDF。”
AI 潇洒地给出一行核心代码:excelTool.magicExportToPdf()。你一跑,终端立刻甩脸报错:“未定义此函数”。你质问它,它还非常客气地道歉:“对不起,是我记错了,请使用 excelTool.convertDirectly()”——好家伙,又是一个它现编出来的假函数!
很多人遇到这种破事,第一反应是:“AI 在骗我!这东西根本不能用于严肃工作。”
其实 AI 从来没有骗你——“欺骗”需要主观恶意。
比被骗更恐怖的真相是:在 AI 的世界里,根本就没有“真”和“假”这两个概念。
二、 揭秘黑盒:它不是真理机器,是“超级概率接龙大师”
要理解 AI 的一切神迹与荒唐,你只需要记住一句话:
大语言模型(LLM)的本质,是一个基于概率的“文字接龙游戏机”(Next-Token Prediction)。
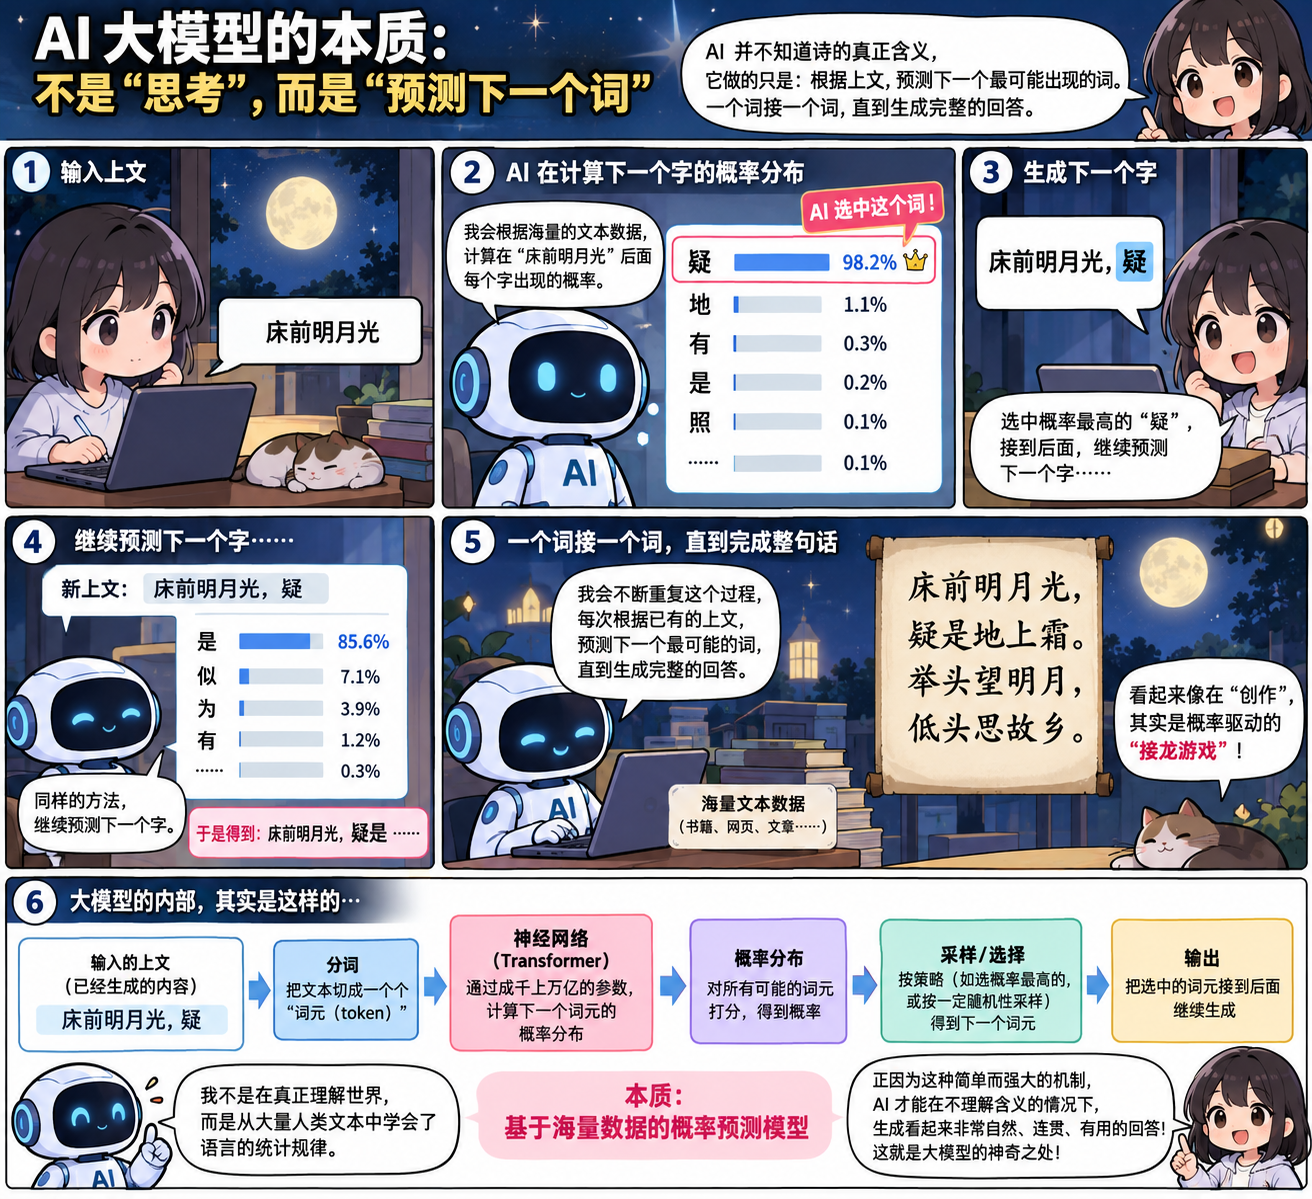
不管你给 AI 抛出多宏大、多严肃的问题,它在大脑内部只做一件事:
“根据前面已经出现的这一堆字,计算出后面接哪个字最合乎常理?”
理解这一点,至关重要:
- 传统计算器的工作方式:输入
1 + 1,调取固定算力,严格输出2。 - 大模型的工作方式:读完了海量互联网文本后,它发现当出现
1 + 1 =时,后面跟着2的概率高达 99.999%,于是它吐出了2。
这就解释了为什么它会胡说八道:
AI 追求的终极目标,从来不是“客观真理”,而是“听起来合理(Plausible)”。
当它编造不存在的论文或代码函数时,它的大脑思维是:“在学术论文这种语境下,作者的名字像个学者、文章名字包含几个热门词汇,从语法和结构上看简直太顺畅了!”
它满意地把接龙继续了下去,压根不在乎现实世界里到底有没有这个人。
三、 幻觉(Hallucination)从何而来?
业内管 AI 的这种瞎编叫“幻觉”。很多人问:“既然 AI 这么强大,科学家为什么不在它的肚子里塞一本《新华字典》或者客观事实数据库,不准它编造呢?”
这就是关于大模型的第二个巨大认知误区:
AI 的肚子里,根本没有存储任何一篇文章或代码的原文。
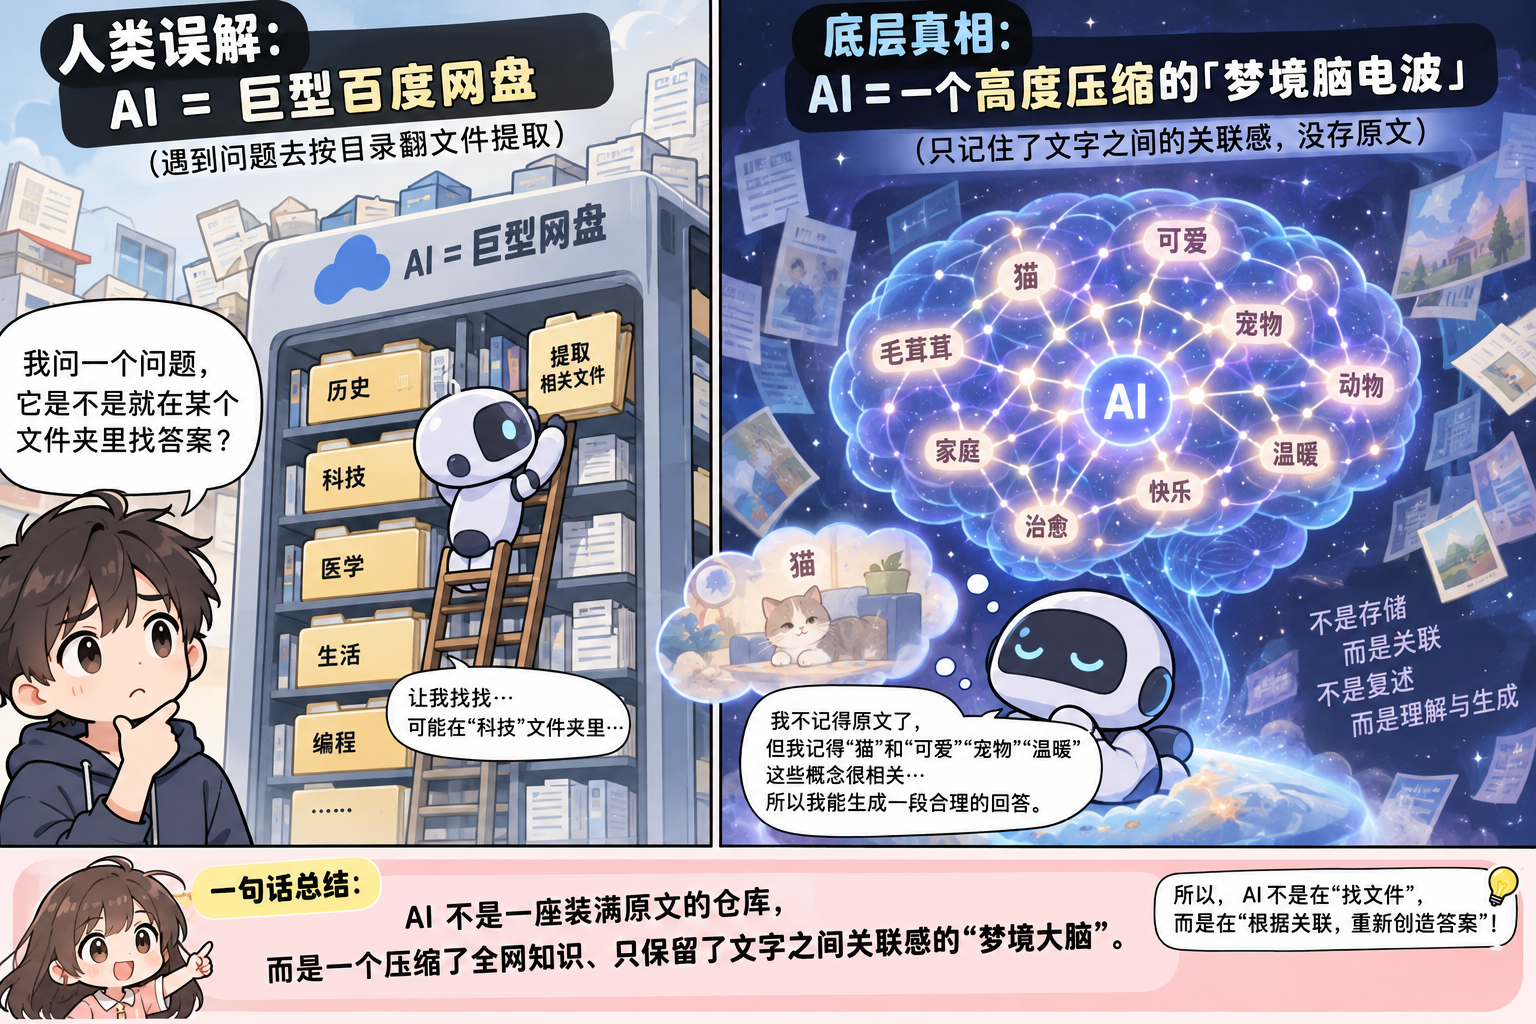
科学家把整个互联网的知识(维基百科、GitHub 代码、Reddit 论坛、电子书)塞进 AI 训练时,并不是把字存下来,而是通过数学计算,把几百 TB 的文字极度压缩成几百亿、几千亿个参数权重。
这就像一个记忆力超群的高中生,考前把三年教材疯狂通读了一遍,进考场时教材全被没收,他只能凭脑子里的模糊印象(权重)来答题:
- 遇到高频知识(如“李白是哪朝人”、“怎么写 Python 冒泡排序”):这在训练集里被翻来覆去强化过上亿次,他的印象无比深刻,几乎不会答错。
- 遇到冷门领域 / 极细技术细节:他的脑子里只有点零碎的印象。但考卷不能空着(系统要求接龙继续),在概率指引下,他的大脑自动开始脑补、联想、拼凑。
划重点:AI 越不懂的东西,它越喜欢用最笃定的语气去编造。
因为在它的概率字典里,“我不知道”往往不是最顺畅的接龙选项,顺着你的问题编一段严谨的假话,概率分数反而最高。
四、 上下文窗口(Context Window):为什么它聊着聊着就变笨、甚至失忆?
做实际项目时,普通人最常遇到的另一个崩溃体验是:
“我和 AI 聊得好好的,帮我写了几千行代码,怎么聊到后面,它突然把我前面定好的规则全忘了?甚至连刚才写的变量名都不认得,越改越烂?”
要搞懂这个问题,你必须先戳破一个最大的假象:你以为 AI 在连续对话时“记得”你,其实每次回答完,它的大脑都会当场清零。
1. 颠覆直觉的真相:每次对话都是一场“滚雪球重发”
大模型的每一次推理,在底层都是完全无状态的(Stateless)。
这意味着:AI 吐完最后一个字的那一秒,它的大脑瞬间恢复成一片空白,把你彻底忘光。
那为什么你在聊天框里还能跟它连续聊下去?
因为你的客户端软件(网页或 Agent 工具)在背后偷偷帮你“打包重发”!
【第 1 轮】你输入:“我叫张三”
 ➔ 实际发给 AI:[我叫张三]
 ➔ AI 回复:“你好张三!”(回复完,AI 大脑当场格式化清零)

【第 2 轮】你输入:“我刚才说我叫什么?”
 ➔ 软件在后台偷偷拼装,实际发给 AI:[第1轮:我叫张三 + 你好张三! + 第2轮:我刚才说我叫什么?]
 ➔ AI 瞬间读完这整包剧本,接龙回答:“你叫张三!”

【第 20 轮】你只输入了两个字:“好的”
 ➔ 实际发给 AI:[系统设定 + 前 19 轮的所有对话、代码、报错日志 + “好的”](足足几万字!)
看到恐怖之处了吗?
所谓的“连续对话”,本质上是把以前的聊天记录和 AI 自己整理的资料,像滚雪球一样,在每一次提问时从头到尾重新喂给它一遍!
2. 办公桌比喻与“变笨”的两大诱因
既然每次都要把整包历史记录重新铺在 AI 面前,这就撞上了一个物理极限——上下文窗口(Context Window)。
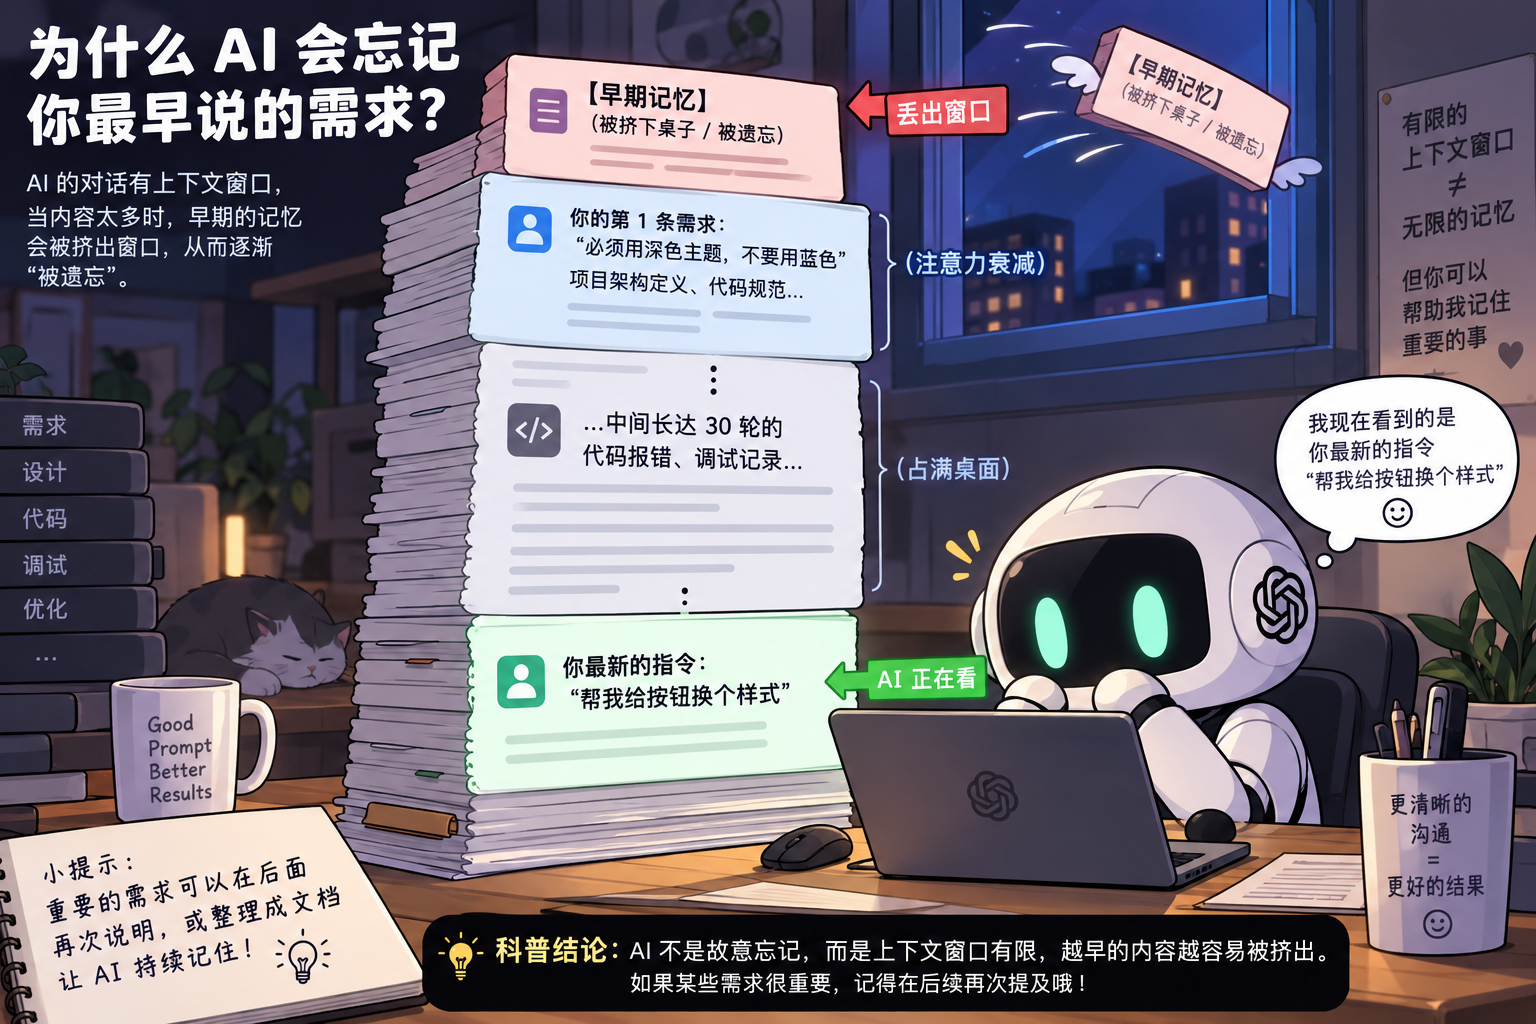
你可以把上下文窗口,想象成这位失忆打工人面前的办公桌桌面大小:
- 每次你发消息,软件就把以前所有的草稿纸全铺在桌面上,让他从头看一遍再往下写。
- 但桌面不是无限大的(哪怕现在有宣称几十万、上百万 Token 容量的模型,桌子变大了,它的阅读精力依然有限)。
随着雪球越滚越大,两个致命问题必然爆发:
- 信息被挤出窗口(Truncation):当整包对话历史太长,超过了桌面的最大容量,最前面的纸张就会被无情地推下桌子。它不是故意违背你早期的设计,它是真的“物理性看不见”了。
- 注意力稀释与污染(Lost in the Middle):就算桌子足够大,但如果桌上堆满了 20 轮失败的报错日志、废弃的代码片段,AI 每次重读这堆垃圾时,注意力就会被严重干扰。它会产生思维定势,在错误的泥潭里越陷越深。
3. 现代 Agent 的两大续命黑科技:压缩与缓存命中
听到这里,聪明的你一定会冒出两个疑问:
“既然像滚雪球一样每次都重发几万字,那聊上几十轮,窗口岂不是早就炸了?而且每次都按字数计费,我的钱包岂不是早就破产了?”
如果在两年前,确实如此。但在今天,现代大模型与 Agent 工具(如 Claude Code、Cursor、DSH 等)进化出了两大核心机制,才让长线干活变得既聪明又用得起:
【黑科技一:上下文自动压缩 (Context Compaction)】 ──► 解决“桌子塞满变笨”
当桌面快堆满时,Agent 触发压缩机制:把前 30 轮啰嗦的对话和报错过程,
由 AI 自己提炼成一份几百字的《阶段性工作摘要》,扫掉废纸,腾出干净桌面继续干活!

【黑科技二:上下文缓存命中 (Prompt Caching)】     ──► 解决“滚雪球扣费破产”
虽然第 20 轮依然要把前 19 轮发过去,但云端服务器发现:“咦?前 19 轮的内容跟上次一模一样!”
于是直接触发【缓存命中 (Cache Hit)】,不需要重新计算,这部分历史记录的扣费直接打 1 折(省 90%)!- 上下文压缩(Compaction):现在的 Agent 不会傻乎乎地把所有历史原封不动留着。当上下文达到警戒线(或你主动执行
/compact),它会把冗长的过程浓缩成“核心结论与当前状态”,实现无损瘦身。 - 缓存命中(Prompt Caching):这是现代 AI 编程能普及的底层经济支柱。只要前面的对话历史(前缀)保持不变,后续每一轮重发时,绝大部分历史 Token 都会命中云端高速缓存——不仅响应速度翻倍,而且缓存命中的费用通常只有原价的 10% 甚至更低。
💡 顺便懂一个省钱冷知识:
为什么在使用 Agent 时,不要频繁在中途去修改系统最顶部的规则或随意增删早期消息?因为一旦开头的文字变了,后面的“缓存队列”就会全部失效(Cache Miss),系统不得不按全价重新计算整张桌子上的所有字!
五、 认知重塑:如何让“概率接龙怪”乖乖说真话?
知道了 AI 的底层缺陷与上下文机制,我们不是要放弃它,而是要像老练的项目总监一样,在管理上建立防范机制。
掌握下面三条法则,你就已经走在绝大多数用户前面了:
| 面对的问题 | 错误姿势(新手思维) | 正确姿势(AI-Native 架构思维) |
|---|---|---|
| 容易出现幻觉 | 考它闭卷考试:“你给我凭空写一个冷门库的代码。” | 开卷考试(提供参考源):“这是这个库的官方文档片段(粘贴或接入),请严格基于文档写代码。” |
| 喜欢不懂装懂 | 任由它随意发挥。 | 施加负面约束:“如果在文档中找不到依据,请直接回答‘无法确认’,严禁自己捏造任何参数。” |
| 聊太长越改越烂 | 在一个对话框里死磕 3 天,顶着满桌垃圾日志求它修 Bug。 | 主动压缩或果断断舍离:善用 Agent 的上下文压缩功能,或者提炼当前核心状态,开一个干净的新窗口重新发问。 |
一句话总结它的心智模型:
永远不要把大模型当成算无遗策、拥有永恒记忆的神;把它当成一个每次进门都失忆、全靠看桌上笔记接龙、读过人类大部分网页但随时可能吹牛的超级实习生。
你的价值,就是帮他管好桌上的笔记,给他提供准确的参考资料,并在关键节点进行核查把关。
📝 结语与本篇自查
- AI 吐出的代码里出现了一个根本不存在的报错函数,是它故意在骗你吗?
(不是。它只是基于概率接龙,算出了一个最像真实代码的词,它没有真理概念。) - 在连续对话的第 10 轮,你只发了一句“继续”,后台实际发送给大模型的是什么?为什么没有让你扣费破产?
(后台实际把“前 9 轮完整对话记录 + 继续”打包全发了过去。没破产是因为触发了云端的“缓存命中(Prompt Caching)”机制,未变动的前缀历史享受了极低折扣。) - 一个会话聊了很久,AI 突然开始重复犯同样的低级错误,背后的物理原因和最佳解法是什么?
(原因是上下文窗口被大量历史报错日志污染,导致注意力稀释。最佳解法是触发上下文压缩(Compact),或提炼有用进展后新建干净会话。)
下一篇预告:
既然许多原生的“裸大模型”天生是个瞎子(纯文本无视觉)、是个断网者(不知道最新技术)、记忆还全靠临时塞笔记……那我们怎么在实际项目中给它“外挂义肢”?
在下一篇《给 AI 装上器官:破解多模态、实时性与短期记忆硬伤》中,我们将进入硬核工程认知,教你如何利用外置视觉小模型、Tavily 专用搜索雷达与本地 Markdown 记忆体系,把这个偏科的实习生打造成全副武装的特种兵。